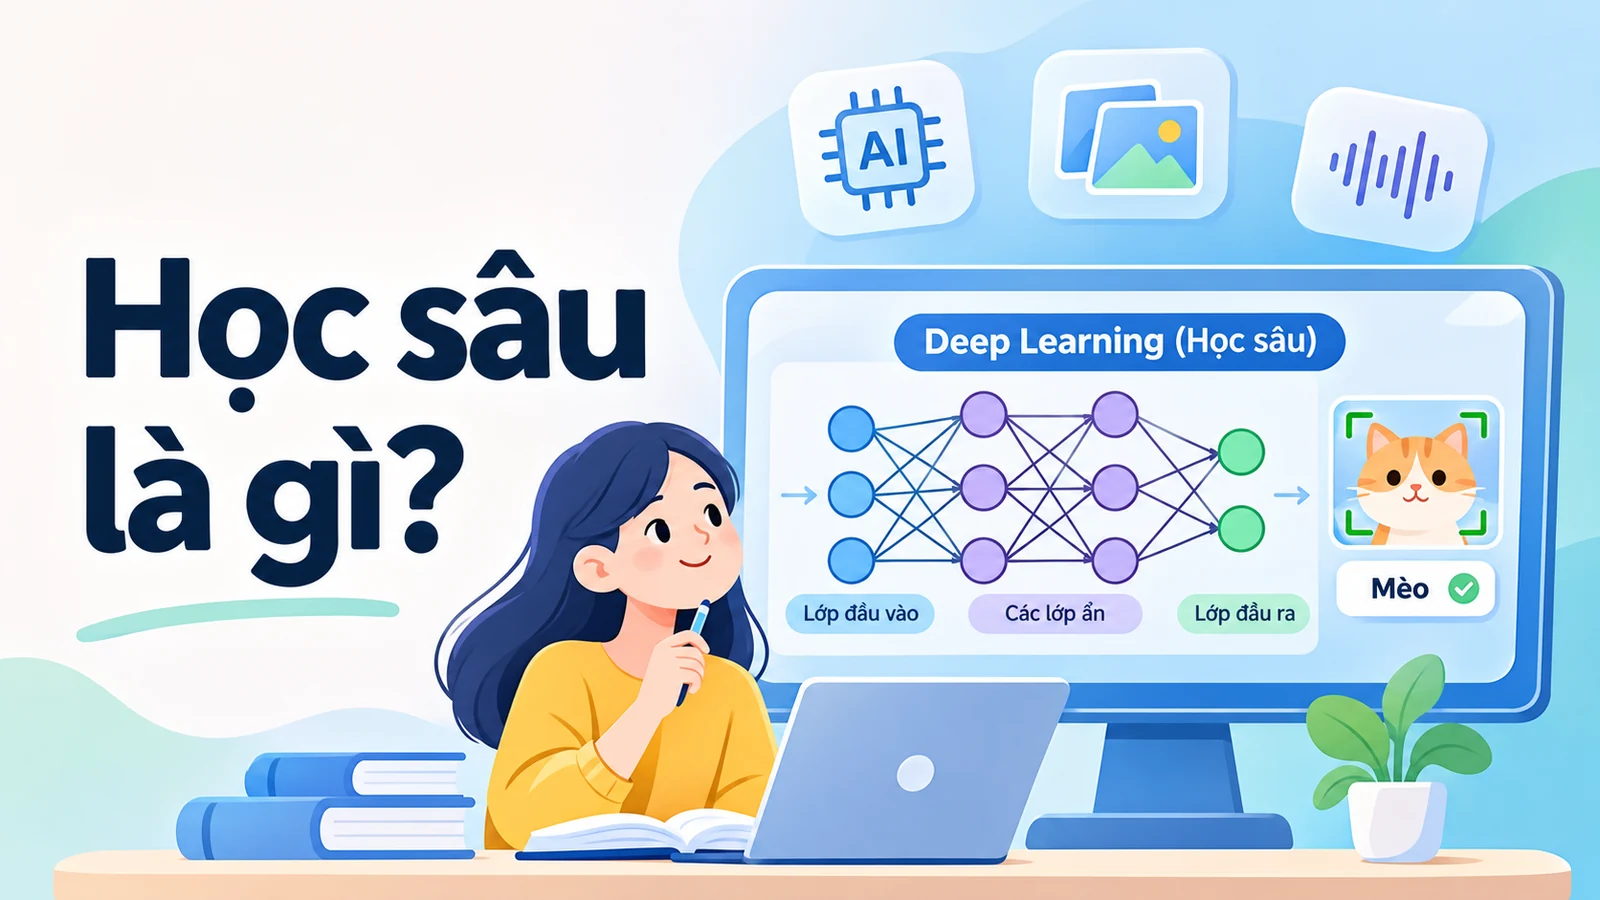
Một ứng dụng có thể nhận diện con mèo trong ảnh, chuyển giọng nói thành văn bản hoặc gợi ý cách hoàn thành một câu. Đằng sau nhiều khả năng đó là học sâu (Deep Learning), một phương pháp thuộc lĩnh vực học máy.
Nhưng máy tính thực sự học được điều gì, các lớp nơ-ron có vai trò ra sao và tại sao cùng một mô hình đôi khi dự đoán sai? Bài giảng này đi từ bản chất đến một quy trình triển khai có thể kiểm chứng.
1. Học sâu (Deep Learning) là gì?
Học sâu là một hướng tiếp cận của học máy sử dụng các mô hình gồm nhiều tầng biến đổi để tự hình thành những cách biểu diễn dữ liệu hữu ích cho một nhiệm vụ. Phổ biến nhất là các mạng nơ-ron nhân tạo nhiều lớp, được huấn luyện bằng dữ liệu và tối ưu hóa các tham số. Thay vì yêu cầu lập trình viên mô tả thủ công tất cả quy tắc nhận diện, mô hình điều chỉnh các tham số sao cho đầu ra phù hợp hơn với mục tiêu đặt ra. www.deeplearningbook.org
Hãy hình dung nhiệm vụ phân biệt ảnh mèo với ảnh chó. Một chương trình dựa hoàn toàn vào quy tắc viết tay có thể tìm tai nhọn, râu hoặc hình dạng mõm, nhưng các dấu hiệu này không ổn định khi ảnh bị che khuất hoặc thay đổi góc chụp. Với học sâu, mạng nhận ảnh đã được biểu diễn thành các giá trị số, qua nhiều phép biến đổi rồi tạo ra kết quả dự đoán. Các biểu diễn hình thành trong mạng phụ thuộc vào kiến trúc, dữ liệu và quá trình huấn luyện, không phải mọi lớp đều tương ứng với một đặc điểm dễ gọi tên. cs231n.github.io
Học sâu nằm ở đâu trong AI và Machine Learning?
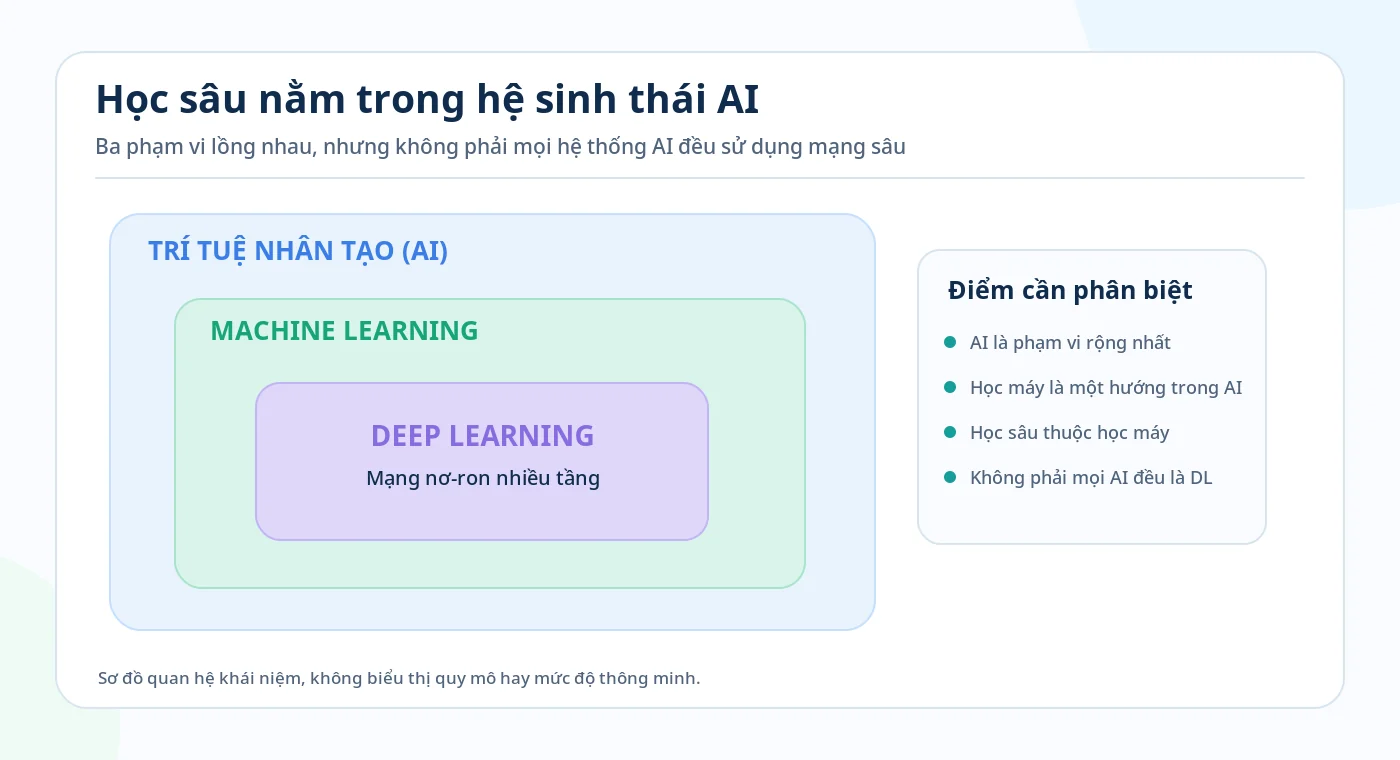
Trí tuệ nhân tạo (Artificial Intelligence, AI) là lĩnh vực rộng về các hệ thống thực hiện những nhiệm vụ thường gắn với năng lực trí tuệ. Machine Learning là một nhóm phương pháp trong AI, nơi mô hình rút ra quy luật từ dữ liệu. Deep Learning là một hướng trong Machine Learning, tập trung vào các mô hình học biểu diễn qua nhiều tầng. Mối quan hệ này không có nghĩa mọi hệ thống AI đều sử dụng học máy hoặc mọi thuật toán học máy đều là mạng nơ-ron.
Để hiểu các phương pháp học máy phổ biến trước khi đi sâu vào mạng nơ-ron, bạn có thể xem bài Machine Learning là gì? trên TrangEdu.
Vì sao gọi là “sâu”?
Từ deep nói đến độ sâu của chuỗi phép biến đổi, thường thể hiện qua nhiều lớp xử lý. Các lớp gần đầu vào tiếp nhận những biểu diễn còn tương đối trực tiếp; những lớp tiếp theo kết hợp và biến đổi chúng phục vụ mục tiêu dự đoán. Tuy nhiên, không có quy tắc thống nhất rằng cứ đúng một số lớp cố định thì mô hình được gọi là học sâu. Chỉ đếm lớp cũng không cho biết chất lượng mô hình.
2. Mạng nơ-ron nhân tạo xử lý thông tin như thế nào?
Một mạng nơ-ron nhân tạo gồm những đơn vị tính toán liên kết theo một cấu trúc nhất định. Mạng truyền thẳng đơn giản có lớp đầu vào, một hoặc nhiều lớp ẩn và lớp đầu ra. “Ẩn” chỉ có nghĩa đó là những lớp nằm giữa đầu vào và đầu ra, không phải các lớp không thể kiểm tra được.
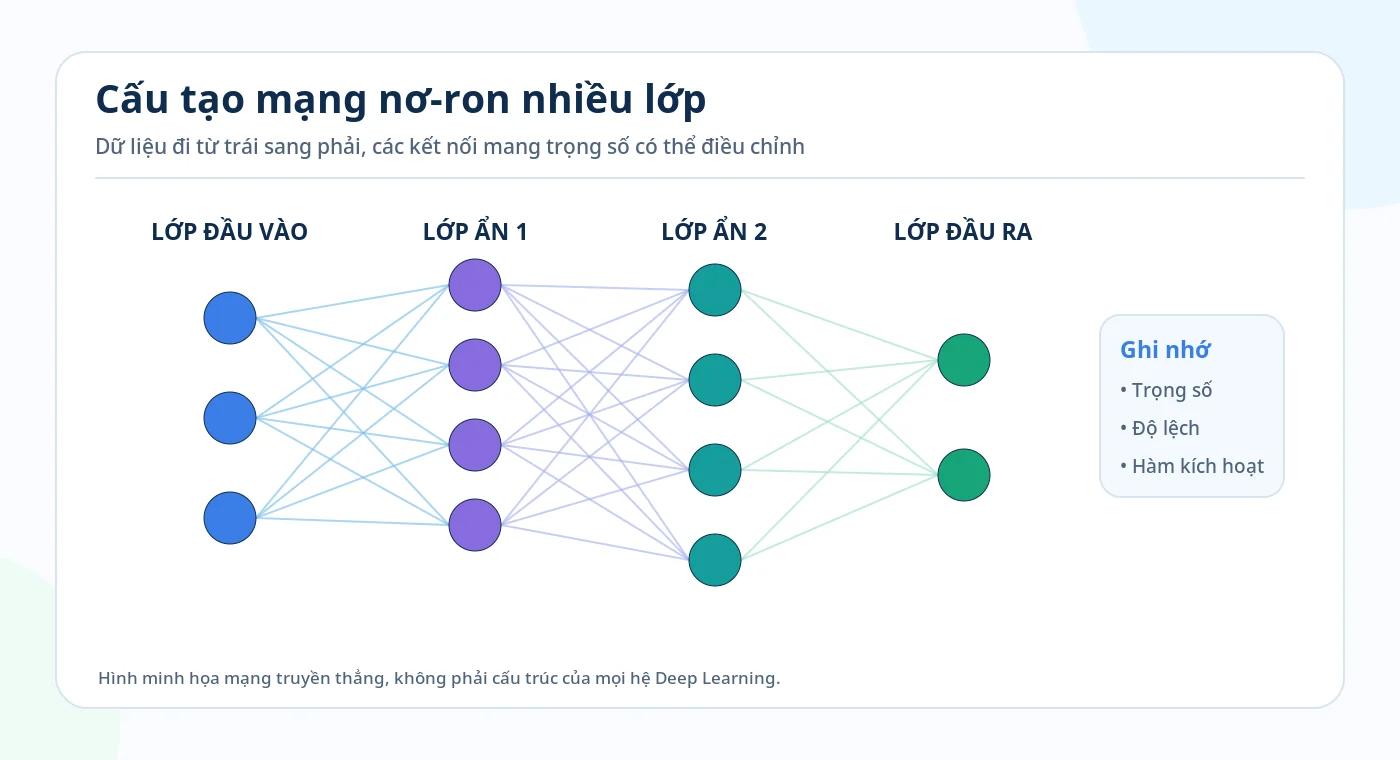
Mỗi kết nối thường mang một trọng số (weight). Đơn vị tính toán cũng có thể có độ lệch (bias). Các giá trị này tạo thành tham số mà mô hình có thể điều chỉnh trong quá trình huấn luyện. Một đơn vị cơ bản thường tính tổ hợp tuyến tính của đầu vào rồi áp dụng hàm kích hoạt (activation function).  Google for Developers
Ví dụ mang tính minh họa, một nơ-ron nhận hai giá trị x₁ = 2 và x₂ = 3, với trọng số w₁ = 0,4, w₂ = 0,2 và độ lệch b = -0,5. Khi đó:
z = 0,4 × 2 + 0,2 × 3 - 0,5 = 0,9
Nếu sử dụng hàm ReLU, tức ReLU(z) = max(0, z), đầu ra của đơn vị này là 0,9. Các con số trên do bài giảng đặt ra để minh họa phép tính, không phải tham số của một hệ thống nhận dạng thực tế.
Vì sao cần hàm kích hoạt phi tuyến?
Nếu nhiều lớp chỉ thực hiện các phép biến đổi tuyến tính liên tiếp, toàn bộ chuỗi có thể được gộp thành một phép biến đổi tuyến tính. Hàm kích hoạt phi tuyến giúp mạng mô tả những quan hệ phức tạp hơn. ReLU là một lựa chọn thông dụng, nhưng mỗi kiến trúc có thể sử dụng các phép biến đổi và hàm kích hoạt khác nhau. Google for DevelopersGoogle for Developers
Đầu ra của mô hình có ý nghĩa gì?
Đầu ra phụ thuộc vào nhiệm vụ. Mô hình phân loại ảnh có thể trả về các điểm số cho từng nhãn; một phép biến đổi như softmax có thể chuyển chúng thành các giá trị không âm có tổng bằng 1. Mô hình dự báo giá có thể đưa ra một giá trị liên tục. Với mô hình ngôn ngữ, đầu ra có thể là phân phối xác suất trên các token tiếp theo. Điểm số cao không bảo đảm dự đoán đúng, và các giá trị softmax cũng không tự động được hiệu chuẩn thành xác suất đáng tin cậy trong mọi bối cảnh. Google for Developers
3. Mô hình học từ dữ liệu theo quy trình nào?
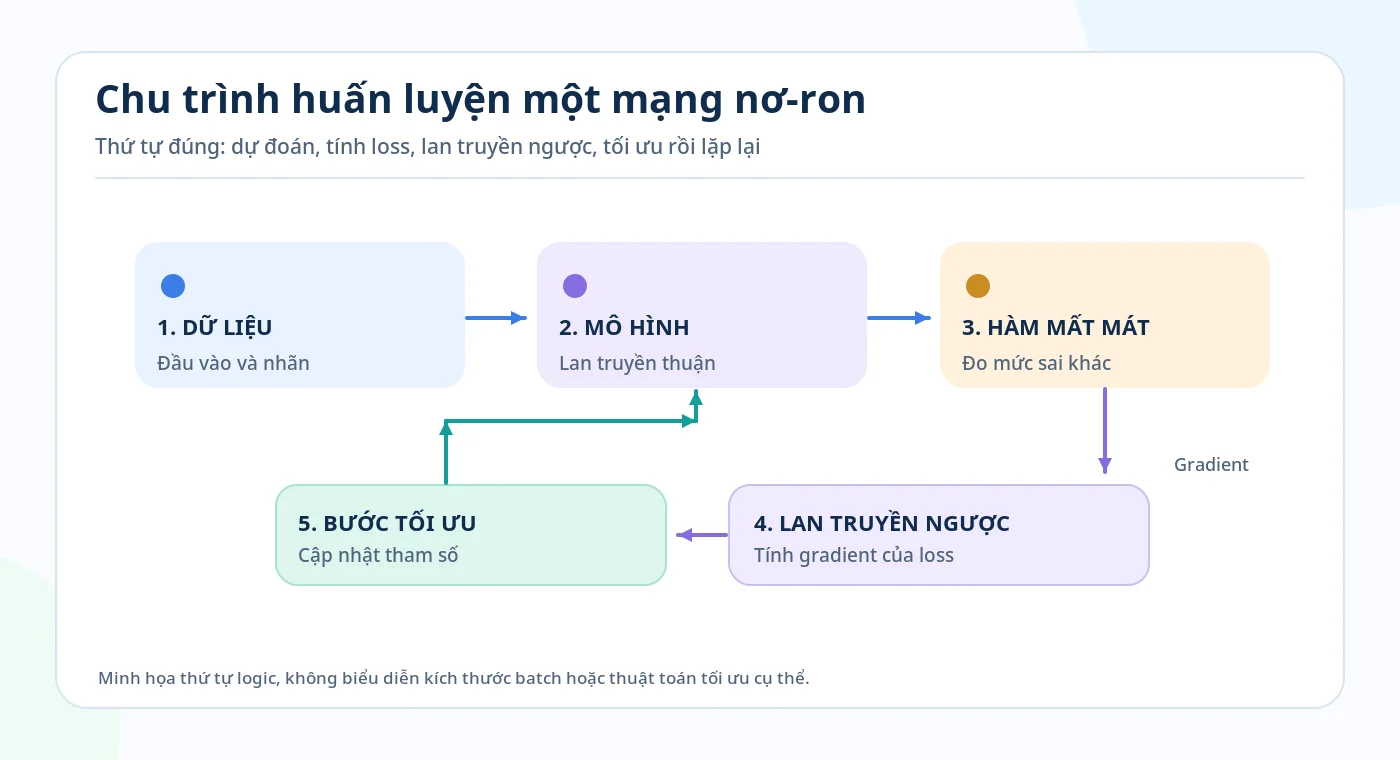
Lúc mới khởi tạo, trọng số của mạng thường chưa giải quyết tốt nhiệm vụ. Trong huấn luyện, một thuật toán tối ưu điều chỉnh các tham số nhằm giảm hàm mất mát (loss function), tức đại lượng phản ánh mức độ sai khác giữa đầu ra dự đoán và mục tiêu huấn luyện. Quy trình cơ bản thường gồm lan truyền thuận, tính mất mát, lan truyền ngược và cập nhật tham số.
Bước 1. Lan truyền thuận và tính sai số
Mô hình nhận một nhóm dữ liệu đầu vào, tính toán lần lượt qua các lớp và tạo dự đoán. Hàm mất mát so sánh dự đoán với mục tiêu đã xác định. Chẳng hạn, với bài toán phân loại ảnh được gắn nhãn, mục tiêu là nhãn đúng của ảnh trong tập huấn luyện. Giá trị mất mát được tính cho một mẫu hoặc tổng hợp trên một nhóm mẫu.
Bước 2. Lan truyền ngược và cập nhật trọng số
Lan truyền ngược (backpropagation) dùng quy tắc dây chuyền của đạo hàm để tính gradient của hàm mất mát theo các tham số. Sau đó, thuật toán tối ưu như gradient descent hoặc một biến thể của nó dùng gradient để cập nhật trọng số. Có thể hiểu trực giác rằng gradient cho biết khi điều chỉnh từng tham số theo một hướng nhỏ thì hàm mất mát biến đổi ra sao tại vị trí hiện tại.  docs.pytorch.orgGoogle for Developers
Phép cập nhật đơn giản của gradient descent có dạng:
w_mới = w_cũ - η × (∂L/∂w)
Trong đó, L là hàm mất mát và η là learning rate (tốc độ học). Learning rate quá lớn có thể làm quá trình tối ưu dao động hoặc phân kỳ; quá nhỏ có thể khiến việc hội tụ chậm. Thực tế còn nhiều yếu tố như kích thước batch, thuật toán tối ưu và cách chuẩn hóa dữ liệu.
Bước 3. Lặp qua dữ liệu và đánh giá
Một epoch thường chỉ một lượt xử lý toàn bộ tập huấn luyện theo quy trình được thiết kế. Batch là nhóm ví dụ được dùng trong một bước cập nhật hoặc tính toán. Mô hình thường được huấn luyện qua nhiều epoch, nhưng không có số epoch mặc định phù hợp với mọi bài toán.
Cần phân biệt hai giai đoạn: training là quá trình điều chỉnh tham số, còn inference là quá trình sử dụng mô hình đã huấn luyện để dự đoán trên đầu vào mới. Khi suy luận thông thường, mô hình không tự thay đổi trọng số chỉ vì có thêm một câu hỏi hay một ảnh được đưa vào.
Học có giám sát, tự giám sát và không giám sát khác nhau ra sao?
Đây là các cách tổ chức tín hiệu huấn luyện, không phải ba loại kiến trúc mạng. Trong học có giám sát (supervised learning), dữ liệu có nhãn hoặc giá trị mục tiêu được cung cấp, chẳng hạn ảnh và tên loài hoa. Với học tự giám sát (self-supervised learning), tín hiệu mục tiêu được tạo từ cấu trúc của chính dữ liệu, ví dụ che một số token rồi yêu cầu mô hình dự đoán chúng. Học không giám sát (unsupervised learning) hướng đến khai thác cấu trúc dữ liệu khi không có nhãn mục tiêu bên ngoài, chẳng hạn tìm những nhóm có đặc điểm gần nhau. Trong thực tế, ranh giới thuật ngữ và cách kết hợp các phương pháp có thể thay đổi theo nhiệm vụ. Google for Developers
Cần phân biệt thêm huấn luyện từ đầu với tinh chỉnh (fine-tuning). Tinh chỉnh tiếp tục điều chỉnh một mô hình đã có tham số được huấn luyện trước để thích ứng với nhiệm vụ hoặc dữ liệu mới. Đây là một chiến lược triển khai, không phải một loại mạng nơ-ron khác.
Vì sao phải chia dữ liệu thành các tập khác nhau?
Một cách tổ chức thông dụng gồm tập huấn luyện (training set) để điều chỉnh trọng số, tập xác thực (validation set) để chọn cấu hình và theo dõi phát triển, cùng tập kiểm thử (test set) để đánh giá cuối cùng trên dữ liệu chưa dùng cho việc chọn mô hình. Không có tỷ lệ chia 70/15/15 hay 80/10/10 bắt buộc cho tất cả bài toán. Cần tránh mẫu trùng lặp và những dạng rò rỉ dữ liệu (data leakage) khiến kết quả đánh giá tốt một cách giả tạo. Google for Developers
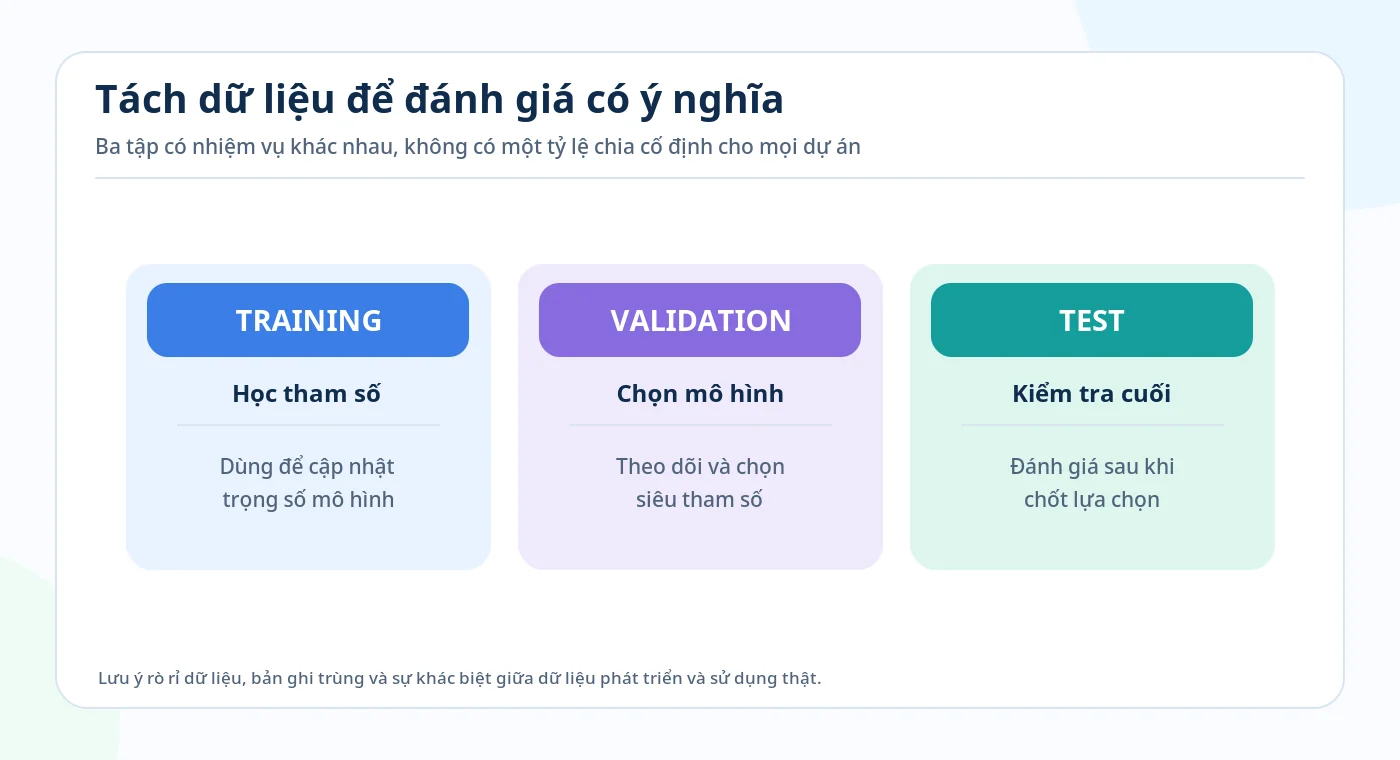
Ví dụ, nếu một bệnh nhân có nhiều ảnh gần giống nhau, việc đặt một số ảnh của họ trong training và số khác trong test có thể khiến phép đánh giá không phản ánh tốt năng lực áp dụng cho bệnh nhân hoàn toàn mới. Đây là tình huống minh họa về rò rỉ thông tin ở mức nhóm, không phải mô tả kết quả của một nghiên cứu cụ thể.
4. Các kiến trúc Deep Learning phổ biến
Học sâu không đồng nghĩa với một mạng nơ-ron duy nhất. Mỗi kiến trúc có đặc điểm xử lý dữ liệu và cách kết nối riêng. Chọn kiến trúc nên bắt đầu từ tính chất của nhiệm vụ, thay vì mặc định mô hình mới nhất sẽ phù hợp nhất.
Mạng truyền thẳng nhiều lớp (MLP)
Multilayer Perceptron (MLP) thường gồm các lớp kết nối dày đặc (dense hoặc fully connected). Mỗi lớp biến đổi đầu vào thành một biểu diễn mới; mô hình phù hợp để minh họa nguyên lý mạng nơ-ron và có thể được dùng với các vector đặc trưng. Tuy nhiên, đối với ảnh lớn, kết nối dày đặc trực tiếp trên từng pixel có thể tạo nhiều tham số và chưa tận dụng tốt cấu trúc không gian. Google for Developers keras.io
Mạng nơ-ron tích chập (CNN)
Convolutional Neural Network (CNN) sử dụng các bộ lọc được học để xử lý cấu trúc không gian cục bộ, đặc biệt quen thuộc trong thị giác máy tính. Bộ lọc được áp dụng qua nhiều vị trí trong ảnh, tạo ra các bản đồ đặc trưng. Các tầng tiếp theo kết hợp thông tin để phục vụ phân loại, định vị hoặc các nhiệm vụ thị giác khác. Không phải mọi CNN đều có lớp pooling; đó là một thành phần thiết kế tùy kiến trúc. cs231n.github.io
Mạng hồi tiếp (RNN) và LSTM
Recurrent Neural Network (RNN) có trạng thái được cập nhật theo chuỗi, từng được sử dụng rộng rãi với văn bản, âm thanh và dữ liệu thời gian. LSTM là một biến thể được thiết kế để hỗ trợ duy trì thông tin qua các bước của chuỗi tốt hơn RNN cơ bản trong nhiều trường hợp. Tuy nhiên, chúng không phải lựa chọn duy nhất cho dữ liệu tuần tự và không còn chiếm ưu thế trong mọi bài toán ngôn ngữ.
Transformer và cơ chế attention
Transformer là một họ kiến trúc sử dụng cơ chế attention làm thành phần trọng tâm. Với self-attention, biểu diễn của một token có thể được cập nhật dựa trên thông tin từ những token khác trong phạm vi được phép chú ý. Điều này giúp mô hình khai thác ngữ cảnh; cơ chế attention không đồng nghĩa với việc mô hình có khả năng xác minh sự thật. Công trình Attention Is All You Need giới thiệu kiến trúc Transformer năm 2017.  arXiv.orgGoogle for Developers
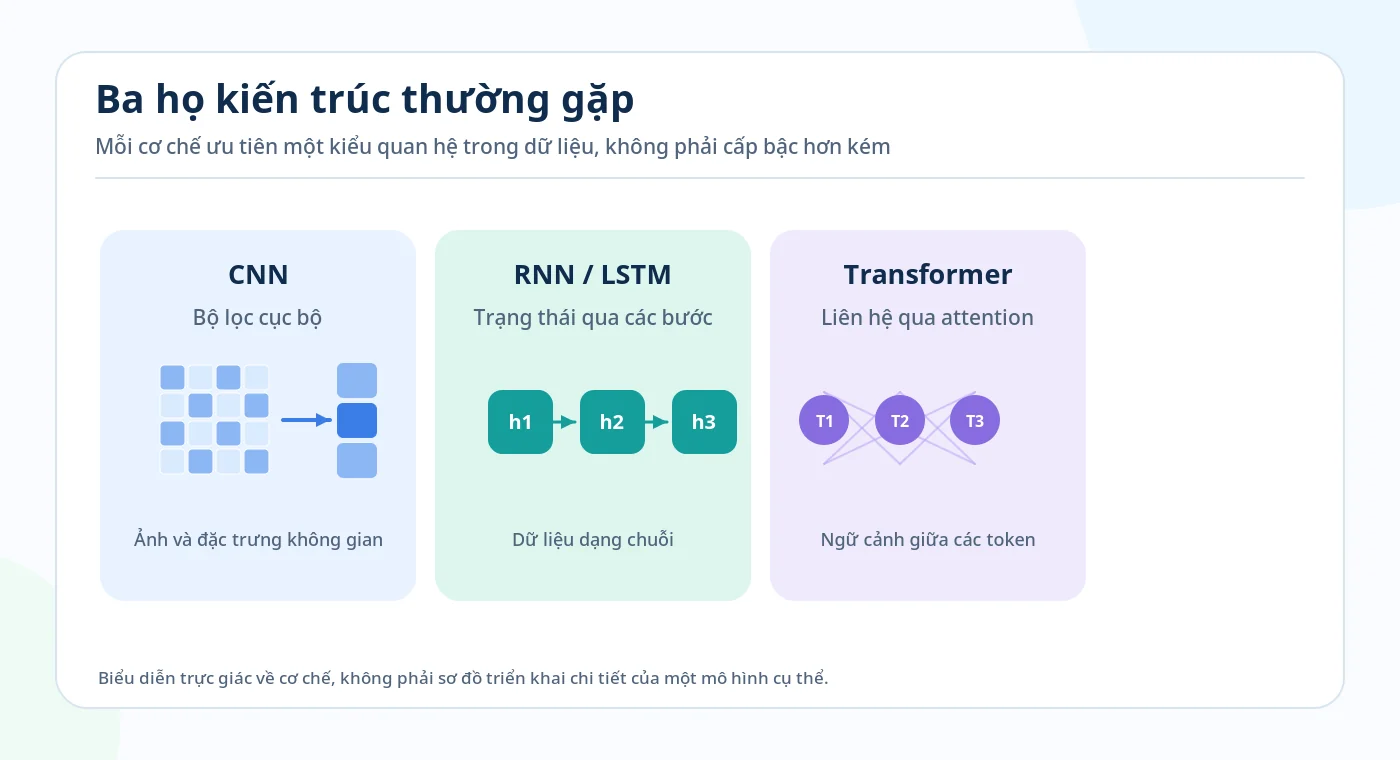
Các mô hình ngôn ngữ lớn (LLM) hiện đại thường sử dụng biến thể Transformer. Tuy nhiên, Deep Learning không đồng nghĩa với LLM hoặc AI tạo sinh. CNN phục vụ nhiều bài toán thị giác, còn mô hình tạo sinh có thể sử dụng những họ kiến trúc và mục tiêu huấn luyện khác nhau.
5. Deep Learning khác Machine Learning truyền thống ở điểm nào?
Deep Learning là một phần của Machine Learning, không phải công nghệ tách biệt hoàn toàn. Khi so sánh, khái niệm Machine Learning truyền thống thường được dùng để chỉ các phương pháp không phải mạng sâu, chẳng hạn hồi quy, cây quyết định hoặc mô hình dựa trên đặc trưng đã thiết kế. Đây là cách so sánh hai nhóm phương pháp chứ không phải hai ngành loại trừ nhau. www.deeplearningbook.org
| Tiêu chí | Machine Learning truyền thống | Deep Learning |
|---|---|---|
| Cách khai thác đặc trưng | Thường dựa nhiều hơn vào đặc trưng do chuyên gia chuẩn bị | Có khả năng học biểu diễn qua nhiều tầng ngay trong mô hình |
| Loại dữ liệu phù hợp | Thường là lựa chọn mạnh với dữ liệu bảng có cấu trúc | Thường phát huy tốt với ảnh, âm thanh, văn bản và dữ liệu phức tạp |
| Dữ liệu và tính toán | Nhiều mô hình hoạt động tốt trong điều kiện tài nguyên vừa phải | Các mô hình lớn có thể cần nhiều dữ liệu và năng lực tính toán hơn |
| Khả năng giải thích | Một số mô hình đơn giản dễ giải thích | Nhiều mạng sâu khó giải thích trực tiếp quyết định cụ thể |
| Lựa chọn cuối cùng | Phụ thuộc bài toán, dữ liệu và mục tiêu triển khai | Không mặc nhiên vượt trội trong mọi trường hợp |
Bảng nêu xu hướng thường gặp, không phải quy tắc tuyệt đối. Một mô hình học sâu nhỏ có thể chạy trên thiết bị hạn chế, trong khi một hệ thống học máy không dùng mạng sâu cũng có thể rất phức tạp. Với dữ liệu bảng không lớn, thử một mô hình tuyến tính hoặc cây quyết định làm đường cơ sở (baseline) thường là lựa chọn hợp lý trước khi đầu tư vào mạng sâu.
6. Học sâu được ứng dụng vào những công việc nào?
Nhận dạng và phân tích hình ảnh
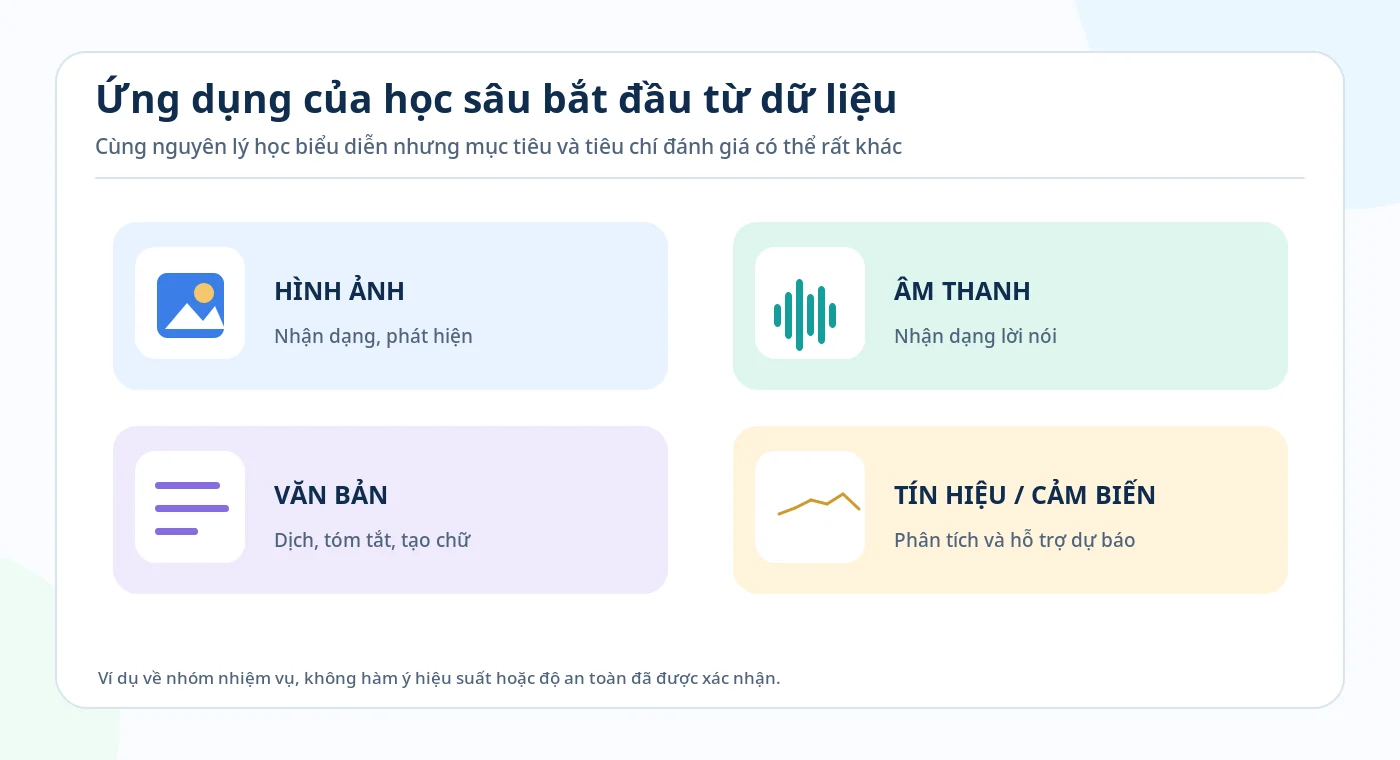
Trong thị giác máy tính, học sâu được sử dụng cho phân loại ảnh, phát hiện vật thể và phân đoạn hình ảnh. Ví dụ, hệ thống kiểm tra sản phẩm có thể hỗ trợ phát hiện một số dạng lỗi từ ảnh chụp trong dây chuyền. Hiệu quả thực tế phụ thuộc nhiều vào chất lượng ảnh, mức độ đại diện của tập dữ liệu và yêu cầu kiểm tra trên điều kiện vận hành thật. CNN là một nhóm kiến trúc quen thuộc của lĩnh vực này.  TensorFlow
Nhận dạng tiếng nói và xử lý ngôn ngữ
Mạng sâu có thể hỗ trợ chuyển giọng nói thành văn bản, dịch máy, tìm kiếm ngữ nghĩa, tóm tắt hoặc tạo văn bản. Chẳng hạn, một mô hình ngôn ngữ dự đoán các token dựa trên ngữ cảnh đã có, nhưng việc tạo ra câu văn mạch lạc không chứng minh mọi khẳng định trong câu đều chính xác.
Hỗ trợ phân tích dữ liệu chuyên ngành
Trong y tế, sản xuất hoặc nghiên cứu, mạng sâu có thể hỗ trợ phân tích ảnh và tín hiệu. Tuy nhiên, một kết quả dự đoán không thay thế quy trình thẩm định chuyên môn; ứng dụng có ảnh hưởng lớn đến con người cần được đánh giá về độ an toàn, sai lệch, bảo mật, tính phù hợp và trách nhiệm sử dụng.  NIST
Hệ thống gợi ý và AI tạo sinh
Mô hình sâu cũng có thể học cách biểu diễn người dùng và nội dung để hỗ trợ gợi ý, hoặc học phân bố dữ liệu để tạo ra văn bản, hình ảnh hay âm thanh mới. Đây là các hướng ứng dụng, không phải bằng chứng rằng chỉ cần dùng Deep Learning thì hệ thống gợi ý luôn tốt hơn hay nội dung tạo ra luôn đáng tin cậy.
Nếu muốn nhìn rộng hơn về các hướng xây dựng hệ thống thông minh, bạn có thể tham khảo bài AI là gì? trên TrangEdu.
7. Hạn chế và rủi ro của Deep Learning
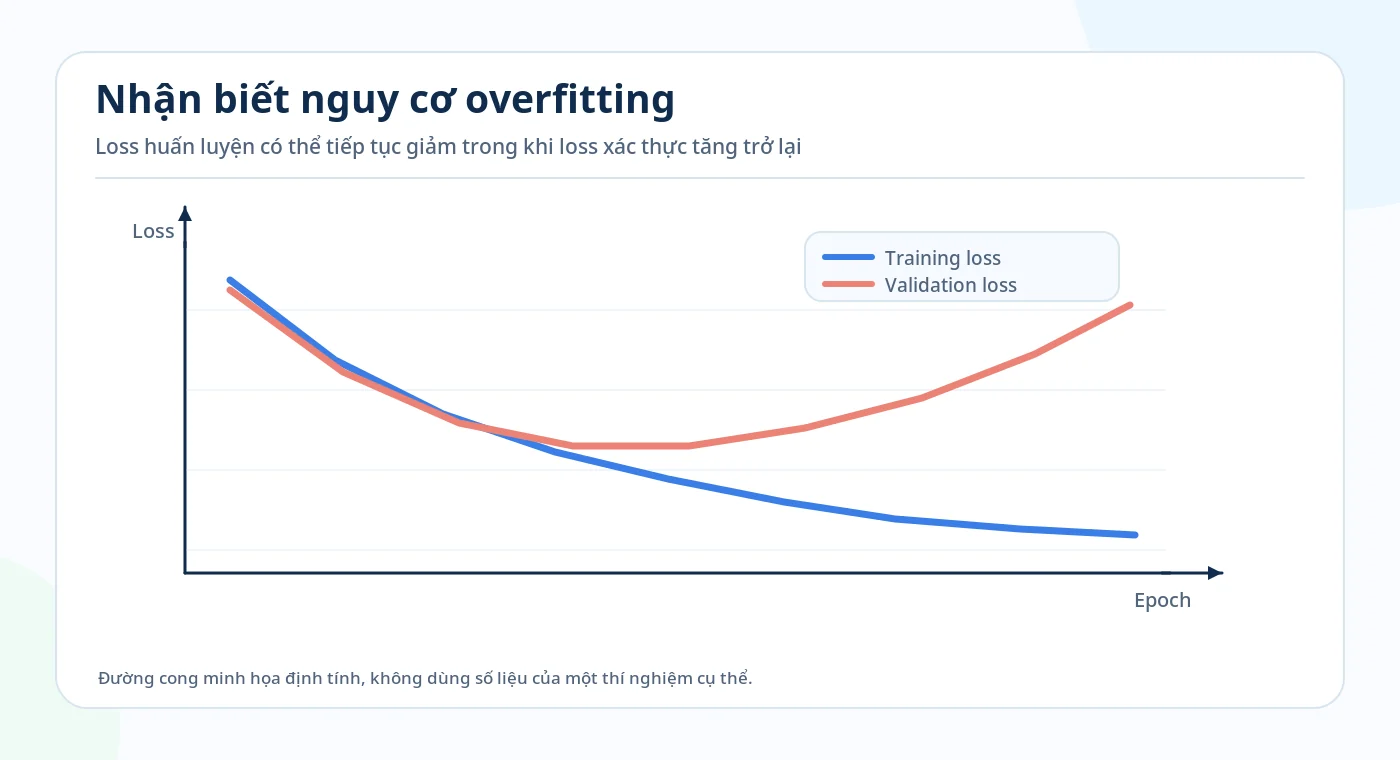
Một mô hình có mất mát huấn luyện thấp chưa chắc hoạt động tốt trên dữ liệu mới. Tình trạng overfitting xuất hiện khi mô hình khớp quá sát dữ liệu huấn luyện nhưng không khái quát tốt. Đây là lý do cần theo dõi kết quả trên tập xác thực và giữ tập kiểm thử độc lập.
Những rủi ro cần đánh giá trong dự án thực tế gồm: dữ liệu thiếu đại diện khiến hệ thống sai với một số nhóm trường hợp; dữ liệu thay đổi theo thời gian; chi phí huấn luyện và suy luận; hạn chế về khả năng giải thích; rủi ro quyền riêng tư, bảo mật và sử dụng kết quả không đúng bối cảnh. Với hệ thống tạo sinh, còn có nguy cơ tạo thông tin không chính xác nhưng diễn đạt rất thuyết phục.
Ví dụ giả định: Một mô hình phân loại ảnh lá cây đạt kết quả tốt trên ảnh chụp nền trắng trong phòng nhưng kém ổn định ngoài trời. Nguyên nhân có thể đến từ ánh sáng, phông nền hoặc góc chụp khác với dữ liệu phát triển mô hình. Không thể kết luận đó là do mạng chưa đủ sâu; trước hết cần kiểm tra dữ liệu và quy trình đánh giá.
Một dự án có trách nhiệm cần xác định tiêu chí thành công, dữ liệu đại diện, cách đo sai số, cơ chế giám sát sau triển khai và người chịu trách nhiệm khi hệ thống đưa ra kết quả sai. NIST
8. Quy trình bắt đầu một dự án học sâu nhỏ
Giả sử bạn muốn xây dựng mô hình phân biệt ảnh hai loại hoa. Đây là tình huống minh họa quy trình, không phải dự án đã chạy thử hay báo cáo độ chính xác thực nghiệm.
Bước 1. Xác định nhiệm vụ. Đầu vào là ảnh, đầu ra là một trong hai nhãn hoa. Cần mô tả những trường hợp khó, chẳng hạn ảnh mờ hoặc có nhiều bông hoa, trước khi chuẩn bị dữ liệu.
Bước 2. Chuẩn bị dữ liệu và nhãn. Thu thập ảnh có quyền sử dụng phù hợp, kiểm tra nhãn, chuẩn hóa định dạng và phát hiện ảnh trùng. Nếu nhiều ảnh cùng một cây hoặc cùng một phiên chụp, nên cân nhắc chia theo nhóm thay vì chia ngẫu nhiên từng tệp.
Bước 3. Chia training, validation và test. Chọn cách chia phù hợp để tránh rò rỉ dữ liệu. Chỉ dùng tập test cho đánh giá cuối cùng sau quá trình chọn mô hình.
Bước 4. Xây dựng baseline. Thử một giải pháp tương đối đơn giản, xác định chỉ số đánh giá và đo thời gian suy luận. Sau đó mới lựa chọn CNN nhỏ hoặc tận dụng mô hình được huấn luyện trước phù hợp. Không cần tự huấn luyện một mạng rất lớn từ đầu để làm bài toán nhỏ.
Bước 5. Huấn luyện và theo dõi. Ghi lại loss, chỉ số trên validation và cấu hình thử nghiệm. Nếu kết quả validation xấu đi trong khi training tiếp tục tốt lên, cần xem xét overfitting, tính đại diện của dữ liệu và điều chỉnh quá trình huấn luyện.
Bước 6. Đánh giá lỗi và triển khai có kiểm soát. Xem những trường hợp mô hình sai, kiểm tra dữ liệu mới, đo hiệu năng và xác định quy trình giám sát sau triển khai. Một chỉ số tổng hợp duy nhất chưa phản ánh hết độ tin cậy trong thực tế.
Nếu muốn triển khai thử nghiệm bằng mã, bạn nên có nền tảng Python là gì? trước khi làm quen với thư viện TensorFlow hoặc PyTorch. Hướng dẫn phân loại ảnh của TensorFlow trình bày một quy trình tương tự, từ đọc dữ liệu, xây dựng mô hình, huấn luyện đến cải thiện và đánh giá.
9. Những hiểu lầm thường gặp
“Deep Learning hoạt động giống hệt bộ não con người.”
Không chính xác. Mạng nơ-ron lấy cảm hứng từ một số ý tưởng về xử lý tín hiệu sinh học, nhưng các đơn vị tính toán và cơ chế huấn luyện của mạng sâu không phải bản sao đầy đủ của nơ-ron sinh học.
“Càng nhiều lớp thì càng thông minh.”
Không có quy luật như vậy. Chất lượng phụ thuộc kiến trúc, dữ liệu, mục tiêu, tài nguyên và quy trình đánh giá. Tăng độ sâu không phù hợp còn có thể làm huấn luyện khó hơn hoặc tăng chi phí.
“Deep Learning luôn cần dữ liệu cực lớn.”
Không hoàn toàn. Quy mô dữ liệu cần thiết thay đổi theo nhiệm vụ, mô hình và phương pháp. Việc sử dụng mô hình huấn luyện sẵn có thể giúp giải một số bài toán với ít dữ liệu gắn nhãn hơn, nhưng vẫn cần đánh giá độc lập trên bối cảnh sử dụng.
“AI tạo sinh biết điều gì đúng vì đã đọc rất nhiều dữ liệu.”
Không thể suy ra như vậy. Mô hình ngôn ngữ được tối ưu cho những mục tiêu học cụ thể; câu trả lời trôi chảy vẫn có thể sai sự thật hoặc thiếu nguồn kiểm chứng. Google for Developers
Học sâu là phương pháp thuộc học máy, sử dụng nhiều tầng biến đổi để xây dựng biểu diễn dữ liệu phục vụ dự đoán hoặc tạo nội dung. Muốn hiểu một hệ thống Deep Learning, cần nhìn đủ bốn yếu tố: dữ liệu đầu vào, kiến trúc mô hình, mục tiêu và quá trình tối ưu, cách đánh giá trên dữ liệu mới. CNN, RNN và Transformer là những ví dụ về các lựa chọn kiến trúc, không phải ba cấp độ tiến hóa bắt buộc. Một mô hình đáng tin cậy cần được kiểm tra bằng bằng chứng thực nghiệm trong đúng bối cảnh sử dụng, chứ không chỉ dựa vào độ sâu của mạng.
Câu hỏi thường gặp
Học sâu có phải là trí tuệ nhân tạo không?
Có, học sâu thuộc hệ sinh thái phương pháp của AI thông qua Machine Learning. Tuy nhiên, AI còn có những phương pháp khác ngoài học sâu.
Deep Learning và Machine Learning có giống nhau không?
Không hoàn toàn. Deep Learning là một nhánh của Machine Learning. Khác biệt quan trọng là cách sử dụng mô hình nhiều tầng để học biểu diễn, chứ không phải cứ có nhiều dữ liệu thì mặc nhiên trở thành Deep Learning.
Có bắt buộc biết lập trình để hiểu Deep Learning không?
Bạn có thể nắm nguyên lý trước khi biết lập trình. Nếu muốn tự tạo, huấn luyện và kiểm tra mô hình, kiến thức Python, đại số tuyến tính, xác suất và đạo hàm sẽ rất hữu ích.
CNN và Transformer khác nhau ở điểm nào?
CNN được thiết kế với cơ chế xử lý đặc trưng cục bộ, đặc biệt quen thuộc với ảnh. Transformer dựa nhiều vào attention để kết hợp thông tin giữa các vị trí hoặc token. Cả hai đều có thể được điều chỉnh để xử lý nhiều loại dữ liệu.
Học sâu có tự cải thiện khi tôi sử dụng một ứng dụng AI không?
Không nhất thiết. Việc nhận thêm đầu vào trong giai đoạn suy luận không tự động cập nhật tham số. Một ứng dụng chỉ thay đổi mô hình khi có quy trình huấn luyện, tinh chỉnh hoặc cơ chế cập nhật được thiết kế riêng.
Học sâu có thay thế mọi phương pháp học máy khác không?
Không. Với dữ liệu bảng, yêu cầu giải thích cao, ít dữ liệu hoặc giới hạn tài nguyên, những mô hình đơn giản hơn có thể là lựa chọn phù hợp. Quyết định cần dựa trên kiểm thử và yêu cầu thực tế, không dựa trên tên công nghệ.